
Символы в цифровом мире: как компьютеры хранят буквы и знаки
Каждый раз, когда вы набираете сообщение на клавиатуре, компьютер превращает эти простые буквы в сложную последовательность нулей и единиц, скрывающихся в глубинах памяти. Этот процесс как невидимый переводчик определяет, сколько места займет один-единственный символ – от скромного байта до нескольких, в зависимости от языка или системы. Понимание этого механизма раскрывает, почему текстовый файл может неожиданно разрастись, а программы иногда спотыкаются об экзотические эмодзы.
Представьте старинный телеграф, где каждый сигнал – это точка или тире, несущее сообщение через океаны. Современные компьютеры делают нечто схожее, но с битами: наименьшими единицами информации, где 0 либо 1 – это база всего. Когда мы говорим об объеме памяти для одного символа, мы погружаемся в мир кодировок, где ASCII держит крепость для базовых латинских букв, а Unicode открывает двери для глобальных языков.
Эта тема не просто технический пустяк; она влияет на все, от скорости загрузки веб-страниц до хранения данных в облаке. Далее мы разберем, как эволюционировали эти системы и почему один символ может занимать от 1 до 4 байтов, в зависимости от контекста. Готовы? Начнём с основ.
Основы измерения памяти: биты, байты и их роль в кодировании
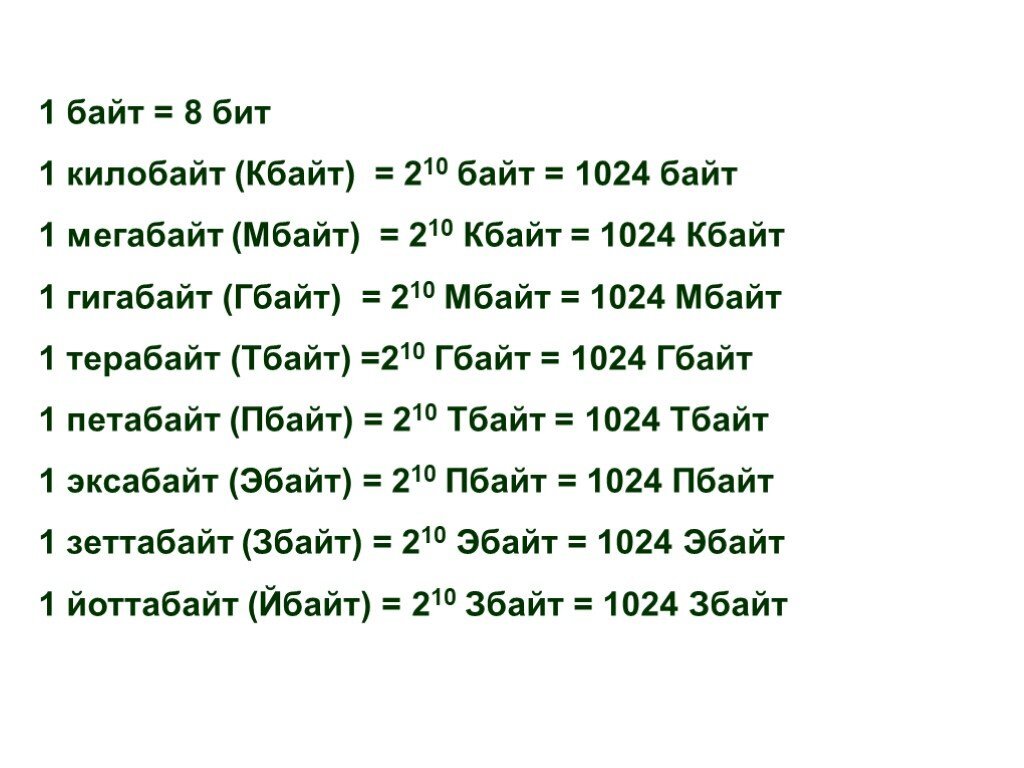
Бит – это фундаментальный строительный блок цифровой информации, как атом в физическом мире, который может быть только в двух состояниях: включен или выключен. Восемь таких битов образуют байт, стандартную единицу, используемую компьютерами для хранения данных. Именно байт определяет, сколько места занимает символ в памяти, потому что каждый символ представляется уникальной комбинацией этих битов.
Представьте байт как маленькую коробку с восемью отделениями, где каждое может содержать 0 или 1. Эта коробка способна представлять 256 различных комбинаций – от 00000000 до 11111111. Для простых символов, как английские буквы, этого хватает с головой, но для сложных коробок, но для сложных. Вот почему объем памяти для одного символа варьируется: в базовых кодировках это 1 байт, а в расширенных – до 4.
Интересно, как это влияет на повседневную жизнь. Например, при сохранении документа в текстовом редакторе программа рассчитывает общий размер файла именно на основе этих байтов. Если текст содержит только латинские символы, файл будет компактным, но добавьте кириллицу или эмодзи – и размер вырастет. Это объясняет, почему некоторые e-mail системы ограничивают объем сообщений, заставляя нас оптимизировать контент.
От бита к байту: простая математика
Один бит несет минимальную информацию, но для символа его маловато – нужна последовательность. Обычно 1 байт = 8 битов, и это стандарт в большинстве систем. Однако, в некоторых архитектурах, как старые мейнфреймы, байт мог быть 6 или 9 битов, что придавало хаосу в ранние дни компьютеризации.
Чтобы сосчитать объем, возьмите символ 'A': в ASCII это 01000001, то есть ровно 1 байт. Но для '😊' в UTF-8 понадобится 4 байта, потому что эмодзи – это сложный код, охватывающий больше комбинаций. Такая вариативность делает программирование увлекательным, но и коварным: ошибка в расчете может привести к переполнению буфера.
На практике разработчики часто игнорируют эти нюансы, предполагая фиксированный размер, что приводит к багам в международных приложениях. Я помню, как однажды проект сорвался из-за неправильной кодировки кириллицы – файл раздулся вдвое, и сервер не выдержал нагрузки.
Различные системы кодирования: от ASCII до Unicode
ASCII, или American Standard Code for Information Interchange, появился в 1960-х как способ стандартизировать символы для компьютеров. Каждый символ здесь занимает точно 1 байт, охватывая 128 базовых знаков: от 'a' до 'z', цифры и пунктуации. Это было революционно для своего времени, как универсальный язык для машин, позволивший обмениваться данными без путаницы.
Но мир не ограничивается английским. Расширенные версии ASCII добавили 128 символов для европейских языков, все еще в 1 байте. Проблема возникла с азиатскими языками, где тысячам символов не хватало места. Здесь на сцену вышел Unicode – глобальный стандарт, поддерживающий более миллиона символов, от египетских иероглифов до современных эмодзи.
Unicode не фиксирует размер: он зависит от реализации. Самый распространенный UTF-8 использует от 1 до 4 байтов на символ, оптимизируя пространство для распространенных знаков. Например, латинский 'A' – 1 байт, кириллический 'А' – 2 байта, а японский кандзи – до 3. Это делает UTF-8 эффективным для интернет, где экономия места критическая.
Подробный разбор UTF-8: переменный размер для гибкости
UTF-8 гениально балансирует между компактностью и универсальностью. Первый байт указывает, сколько байтов следует за ним: если начинается с 0, это 1 байт; из 110 – 2 байта и т.д. Это позволяет сохранять английский текст так же эффективно как ASCII, но расширяться для других языков.
Возьмите символ '€' (евро): в UTF-8 это 3 байта (11100010 10000010 10101100). Почему не меньше? Ибо Unicode назначает ему код U+20AC, требующий больше битов. В программах типа Python функция len() считает байты, а не символы, которые могут запутать новичков – строка из эмодзы будет казаться длиннее, чем есть.
Преимущество UTF-8 в том, что он совместим со старыми системами: ASCII текст читается без изменений. Но в базах данных это может увеличить объем: таблица с миллионом записей, где 10% символов – не-латинские, разрастется на 20-30% больше, чем в чистом ASCII.
UTF-16 и UTF-32: фиксированный размер скорости
UTF-16 использует 2 байта на большинство символов, что делает его популярным в Windows и Java. Базовые символы, как латинские, занимают 2 байта, а редкие – 4 (через суррогатные пары). Это обеспечивает быстрый доступ, потому что размер предполагается, в отличие от UTF-8.
Например, символ 'A' в UTF-16 – 00000000 01000001, то есть 2 байта. Для эмодзы '👍' – 4 байта. Это полезно в играх, где скорость рендеринга текста критична, но тратит больше памяти на простой текст. UTF-32 идет дальше: всегда 4 байта на символ, идеально для систем, где пространство не проблема, как большие базы данных.
В мобильных приложениях UTF-16 может быть лучше, так как процессоры оптимизированы для 16-битных операций. Однако, для веб UTF-8 доминирует, потому что экономит трафик.
Факторы, влияющие на объем памяти символа
Не только кодирование определяет размер: архитектура процессора, язык программирования и операционная система играют роль. В 64-битных системах указатели на строки могут добавлять overhead, делая эффективный объем больше. Кроме того, компрессия, как gzip, может снизить размер файла, но в оперативной памяти символы сохраняются в развернутом виде.
Представьте строку в Java: через UTF-16 она занимает вдвое больше, чем у Python из UTF-8 для того же текста. Добавьте метаданные как кодовые страницы в Windows (например, CP1251 для кириллицы – 1 байт на символ), и картина усложняется. Для разработчиков это осторожный выбор: экономия памяти или универсальность?
Еще один фактор – нормализация: Unicode позволяет комбинированные символы, как 'é' (e+акцент), что может занимать больше байтов, чем прекомпонованный вариант. В базах данных, как MySQL, выбор кодировки (utf8mb4 для полного Unicode) оказывает непосредственное влияние на максимальный размер строк.
Практические примеры и сравнения
Чтобы увидеть разницу наглядно, рассмотрим таблицу, где сравниваем объем памяти для одного символа в разных кодировках. Это поможет понять, почему выбор системы важен для проектов.
| Условное обозначение | ASCII (байты) | UTF-8 (байты) | UTF-16 (байты) | UTF-32 (байты) |
|---|---|---|---|---|
| 'А' | 1 | 1 | 2 | 4 |
| 'А' (кириллица) | Н/Д (расширенный) | 2 | 2 | 4 |
| '€' | Н / Д | 3 | 2 | 4 |
| '😊' | Н / Д | 4 | 4 | 4 |
| '你' (китайский) | Н / Д | 3 | 2 | 4 |
Из таблицы видно, как UTF-8 экономит место для латинских символов, но разрастается для других. В реальном кейсе вебсайт с многоязычным контентом на UTF-8 сэкономит гигабайты трафика по сравнению с UTF-32. Но в мобильных играх UTF-16 ускорит рендеринг, потому что фиксированный размер облегчает вычисление позиций.
Один из моих любимых примеров – эмодзы в социальных сетях. В Twitter сообщения с эмодзы занимают больше байтов, что влияет на предел символов: 'Hello 😊' – это 7 символов, но в UTF-8 около 9 байтов. Это придает шарм, но и вызовы для разработчиков.
Современные тенденции и вызовы в кодировке символов
В 2025 году, с ростом AI и глобализации, кодирование эволюционирует. Новые стандарты Unicode 15 добавляют символы для редких языков, увеличивая потенциальный размер. В облачных сервисах, как AWS, оптимизация памяти для текста становится ключевой: использование UTF-8 с компрессией может снизить затраты на 30%.
Но вызовы остаются: в IoT-устройствах с ограниченной памятью 1 б на символ – роскошь, поэтому применяют специальные кодировки. В криптографии символы кодируются для безопасности, добавляя overhead. Я уверен, что с появлением квантовых компьютеров мы увидим новые парадигмы, где объем памяти для символа станет еще более гибким.
Для программистов совет: всегда проверяйте кодировку файлов. В Node.js, например, неправильный буфер может искажить текст. Это не просто теория – это ежедневная реальность, делающая цифровой мир таким динамичным.
Интересные факты об объеме памяти символов
- 🔤 В ранних компьютерах, как IBM 701 с 1950-х, символы кодировались в 6 битах, позволяя лишь 64 знака – это было как писать сообщения с ограниченным словарем, где не хватало половины алфавита.
- 🌍 Unicode поддерживает более 149 000 символов, но только 1% из них используется каждый день; остальные – это исторические письмена, как клинопись, занимающая 4 байта в UTF-8, словно сохраняя древность в цифровом музее.
- 🤖 Эмодзи '😂' занимает 4 байта в UTF-8, потому что объединяет несколько кодов, и в некоторых системах это вызывает баги – представьте, как один смайлик ломает целую базу данных!
- 🕰 ASCII сначала имел 7 битов, но добавили 8-й для паритета – проверки ошибок, как встроенный детектор лжи для данных.
Эти факты подчеркивают, насколько кодировка – это живая эволюция, полная сюрпризов. Представьте, как один б может изменить весь смысл сообщения в коде. На этом мы не останавливаемся: в мире данных всегда есть место для новых открытий, таких как оптимизация для VR, где символы интегрируются с 3D-элементами.